訓練有效,仍有邊界
《超預測》(Superforecasting)由 Philip E. Tetlock(菲利普·泰特洛克)與 Dan Gardner(丹·加德納)合著,英文版出版於2015年。它討論的不是如何準確説中每一個未來,而是如何讓概率判斷獲得可檢驗的改進。
泰特洛克在《專家的政治判斷》第一章回顧了約二十年的研究,並提出對預測設定共同評分標準的困難。不能把這段研究簡化成“所有專家都和擲骰子一樣”,更不能僅憑上電視或説話自信就判定一個人沒有預測能力。
Good Judgment Project 參與了美國 IARPA 的 ACE 預測競賽。2014年的研究論文分析前兩個賽季,覆蓋2011年9月至2013年4月的199個已結算問題;概率訓練、團隊協作及按前期表現組成的優秀預測者團隊,獲得了更好的評分。參賽者有學歷門檻,樣本也以美國男性為主,結果不能直接擴大為“任何人照做都能勝過情報專家”。
訓練有效,不等於天賦與知識無關。2015年的另一篇論文分析了兩年均參賽、至少提交30次預測的743名預測者,發現認知能力、政治知識、開放思維、訓練條件和投入行為都與準確性有關。訓練和協作來自實驗安排,認知能力及更新頻率等關係不能一概讀成單獨的因果證明。
先把問題寫清楚
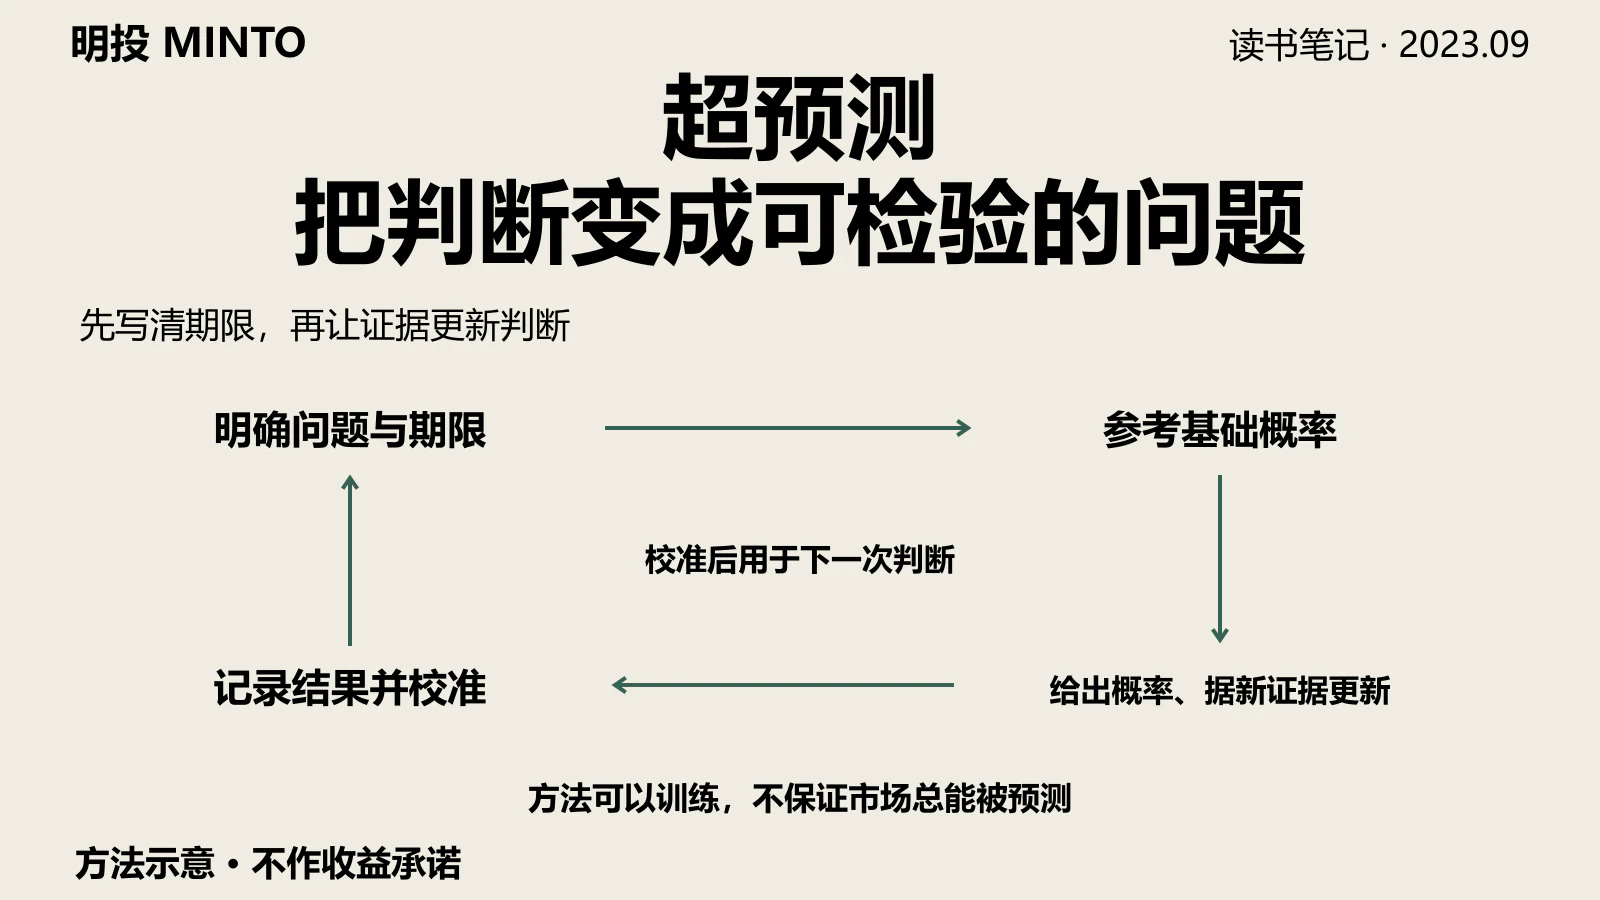
“這家公司會成功”難以評分。成功是營收增長、利潤轉正,還是股價上漲?期限不同,問題也不同。一個可操作的練習,是先明確事件、截止日期和判定來源,再給出概率。
例如,假設要研究某公司下一財年營收同比是否超過10%,就應先寫清使用哪份正式財報、收入單位與會計口徑,以及發生重述時如何處理。這裏的公司和閾值只是方法示例,不是本人的投資記錄,也不是對某家公司的預測。
找歷史參照時,也要核對分母。不能只統計後來成功的公司,再用它們描述全部候選的成功率。拆解問題可以幫助找到關鍵變量,但營收、毛利率與融資條件可能互相影響,不能把幾個主觀概率任意相乘,便得到一個更“科學”的總概率。
新信息應該有機會改變判斷。改變幅度需要由證據決定,不是為了顯得靈活就把70%改為68%。2015年論文報告更新行為與準確性有關,但沒有證明每次立即小幅調整都優於保持原判斷。記錄哪些證據促成變化,才能在結果揭曉後檢查更新是否有幫助。
概率要經得起對賬
70%和75%的區別是否有意義,需要放在一組可評分記錄裏檢驗。把概率寫得精細,不會自動增加信息;一次高概率事件沒有發生,也不能獨自證明預測者沒有能力。
研究論文采用 Brier score 衡量概率預測誤差。沿用論文對兩個結果的平方誤差求和口徑,假設給某事件70%的發生概率:若發生,評分為0.18;若未發生,評分為0.98,越低越好。這是本次按公式計算的示例,不是參賽者成績;只計算一個結果的平方誤差會得到另一種尺度,比較時不能混用。
校準要看多次預測中的概率與實際頻率是否相稱,而非要求每個70%的事件都發生。還需要看預測能否區分不同事件的風險:一直報一個固定概率,並不等於識別了變化。樣本有限、問題相關,都會影響結論;同一事件每天更新的記錄,也不能當成許多個彼此獨立的事件。
IARPA 在2017年的數據公開説明中,將歷年預測資料與研究結果開放供複核,並提到聚合過去表現較好的預測者可以改善預測。本文核驗的是公開説明與論文相關段落,沒有重新計算完整競賽數據,也沒有把數據後來公開的時間寫成原始研究發生的時間。
判斷準確,不等於倉位答案
“發生概率60%”不能直接推出5%的倉位,“90%”也不能直接推出20%的倉位。還要知道價格是否已反映該事件,成功與失敗分別產生多大損益,其他持倉是否承受同一風險,以及交易成本和資金約束。本文不提供從概率直接換算倉位的規則。
賽事以問題結算和評分檢驗準確性,投資要承擔實際損失。長期問題的反饋較慢,能夠評分的問題也未必覆蓋最重要的風險。這些差異需要在遷移方法時檢查,不能從地緣政治競賽推導出金融市場必然可預測,或預測能力必然提高收益。
也不能把地緣政治簡單歸為“沒有反身性”。公開預測可能影響參與者的行動,是否形成反饋,需要看傳播、決策與結果的具體機制。面對風險,預測記錄與損失承受能力應分別複核;改善前者不會自動保障後者。
謙遜也需要成績記錄
“狐狸與刺蝟”可以幫助理解認知風格,但不能成為識別人好壞的捷徑。《專家的政治判斷》第一章既討論狐狸型思維的相對優勢,也指出過度開放可能使人高估過多情景。限定詞多、頻繁改口或名氣小,都不能替代可比較的預測成績。
本文不再把塔勒布概括為“預測無用”,也不把兩位作者的關係寫成未經具體原文核驗的對立故事。原文所謂本人的重倉習慣、80%預測只有60%實現,以及“常規90%/極端10%”“避開90%忽悠”,均缺少可複核記錄,不予保留。
下一次提出判斷時,可以同時留下問題、期限、概率、依據、更新原因與結果來源。結算後把預測與實際結果並排,再與相同問題上的簡單基準比較。若不能定義問題或留下記錄,就先收窄表述,不靠一個更精確的百分比替判斷增加權威。
資料來源
- Penguin Random House:《Superforecasting》出版資料。核驗作者、2015年出版時間及出版介紹,不聲稱完整原版審閲。
- Philip E. Tetlock:《Expert Political Judgment》第一章公開試讀,PDF第1、20至24頁相關段落。核驗研究與評分邊界、狐狸與刺蝟及開放思維的限制;不是整本書的逐章核驗。
- Barbara Mellers 等:Psychological Strategies for Winning a Geopolitical Forecasting Tournament,2014年,PDF第3至4、6至9頁相關方法與討論。核驗賽事時間、樣本門檻、訓練和協作、評分口徑及研究限制。
- Barbara Mellers 等:The Psychology of Intelligence Analysis: Drivers of Prediction Accuracy in World Politics,2015年,PDF第1、6、10至12頁相關摘要、樣本與討論。核驗認知能力、知識及行為關聯,不把統計關聯統一解釋為因果。
- IARPA:ACE 項目説明與2017年4月28日數據公開説明。後者用於確認數據公開與聚合研究方向,未重算完整原始數據。
更正説明(2026年10月3日):保留2023年9月30日原始發表日期。補充合著者與研究範圍,糾正“優勢不來自認知能力與信息”和概率直接決定倉位的説法;撤回沒有記錄支持的個人經歷、比例及作者對立歸屬。區分實驗結果、觀察關聯、本文方法推論與假設計算,保留已驗收封面。

专注投资分析、市场洞察与资产配置。不追短期波动,只理解真正驱动长期回报的东西。