“Welcome to the AGI era.” 欢迎来到AGI时代。
据Axios对发布简报的报道,OpenAI总裁Greg Brockman在GPT-6 Astra发布时,用这句话结束了发言。
理解这句话,可以从OpenAI对AGI的定义入手,再看Astra这次展示了哪些能力。以下沿着OpenAI的章程、发布材料和评测结果,梳理这套表述背后的依据。
OpenAI所说的AGI,落在“自主完成工作”上
在OpenAI章程中,AGI被定义为:能够在大多数具有经济价值的工作中超越人类的高度自主系统。
这一定义包含两个相连的要求。系统要具备跨任务的能力,也要有足够的自主性,把能力用在实际工作中。
沿着这个定义看Astra,发布材料中的电脑操作、科学研究、陌生环境学习和任务边界,就有了共同的指向:用户给出目标后,系统能够理解环境、采取行动,并持续推进任务。
电脑操作,让模型进入实际工作环境
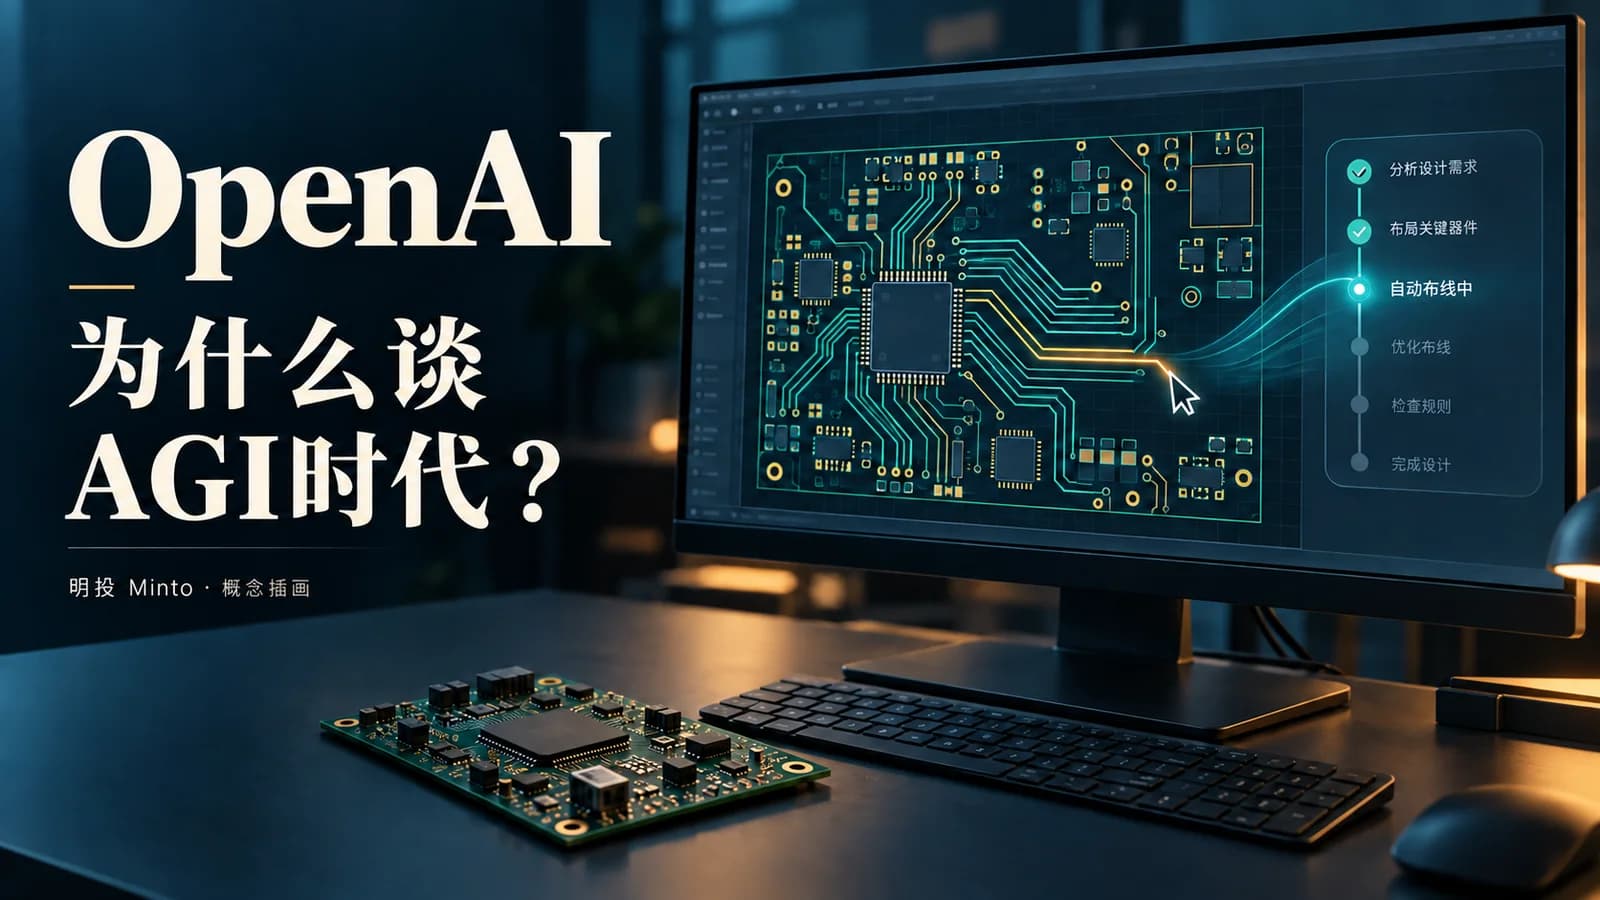
OpenAI在Astra的发布材料中,把电脑使用放在突出位置。官方展示包括填写表单、维护客户记录、处理文档,以及在KiCad中进行电路板布局等任务。
电路板演示给出了一个具体过程:Astra读取电路原理图,在KiCad中放置元件、完成铜线布线,形成电路板布局。网页展示的是15秒压缩回放。这里展示的是从设计输入到软件操作、再到设计输出的一段完整流程。
对于OpenAI章程中“具有经济价值的工作”,这种演示提供了具体的对应场景。工作内容可以是办公室中的文档处理,也可以是工程软件里的设计操作。
OpenAI还披露,在OSWorld 2.0的延迟模拟中,Astra取得72.6%的成绩,每项任务约40分钟;GPT-5.6 Sol为65.7%,约75分钟。这组数字展示的是特定测试配置下,电脑任务表现与完成速度的同步改善。
因此,理解OpenAI这次强调的“自主性”,可以直接观察任务怎样推进:模型是否能够在软件里完成操作,是否能够根据操作结果继续下一步,以及能否减少每一步都由人指挥的需要。
核对41份文件,找出50万英镑的差异
OpenAI公布的Legora客户案例,展示了财务报表核对这一任务:把报表草稿中的数字,与试算平衡表、合并明细和上年报表逐项比对。
据Legora披露,接入Astra的智能体在一次运行中,用数分钟核对了41份文件,找出全部4处预设错误,包括收入附注中50万英镑的差异。它还留下逐项核对记录,供专业人员复核和作出最终判断。
这个案例把“处理大量信息”具体化成了一份核对结果:哪些金额一致,哪里出现差异,每项检查对应什么依据。
做出三种游戏原型,再进入游戏验证
Playco的客户案例展示了另一类工作。团队先建立由简单几何体组成的基础游戏原型,经过玩法和创意调整后,再用Astra从这个基础生成三种主题版本。
据Playco披露,大多数版本首次生成即可运行,其中一个赛博朋克版本需要修复性能问题。相比上一模型,人工修复减少50%。它使用的Playbot开发环境允许模型进入游戏引擎,修改场景、运行游戏并验证修改结果。
从这一流程可以看到,交付物是能够试玩的游戏原型,执行步骤包含制作和运行验证。文档核对与游戏开发,也分别展示了Astra在数字信息处理和交互软件制作中的应用。
ARC-AGI-3展示的是,遇到陌生环境后怎样学习
发布的ARC-AGI-3图表中,Astra的成绩为99.9%。
这项测试让智能体进入陌生的交互环境,探索规则、识别目标,再规划行动。模型需要在与环境的交互中,逐渐形成解决问题的方法。
ARC Prize记录了Astra在测试中的一种行为:它把游戏里的对象、位置和交互关系整理成紧凑的符号表达,用这些记录追踪状态并安排后续动作。
例如,观察到某个操作会改变物体位置之后,模型可以把这一关系保留下来,在后续步骤中继续使用。探索得到的信息由此进入计划,而不只是停留在一次回答里。
ARC Prize还报告,在厂商适配框架、max推理档位下,Astra在96%的关卡中使用的动作数量少于人类基准。这里比较的是完成关卡所需的交互动作,反映它在这些环境中的行动效率。
99.9%对应厂商适配框架、high推理档位;标准框架下的最高成绩为62.7%,对应max档位。厂商适配框架保留跨请求的推理状态,并对长对话进行上下文压缩。
这些条件也解释了Astra怎样连续学习:模型需要保存已经获得的信息,才能把前面的探索用于后面的行动。OpenAI此前关于运行框架的实验,同样把保留推理状态和上下文压缩视为持续执行任务的重要组成部分。
科学研究,把推理与实验过程连接起来
另外两张图展示了Terminal-Bench Science 0.1的结果:一张比较解决率与输出,另一张比较解决率与API成本。
这项测试要求智能体使用代码和终端工具推进科学工作流,涉及数据分析、模拟和模型拟合。OpenAI披露,Astra最高解决率为64.6%,Claude Fable 5.1为52.6%;对应配置下,Astra的估算API成本低约31%。
图中呈现的能力组合,是在研究问题上进行推理,再通过工具执行分析过程。解决率、输出用量和成本被放在一起,展示完成这类任务所需的资源。
科学进展也有测试之外的材料。OpenAI随Astra发布了素数间距研究成果及证明文件。其中,《Improved short gaps between primes》提出:存在无穷多对相邻素数,其间距不超过186。
这一命题讨论的是,无论沿数轴走多远,仍然会不断出现间距不超过186的相邻素数。官方将其列为Astra参与数学研究的成果,并公开了相应研究材料。
从工作类型看,科学分析和数学研究把能力范围扩展到了知识探索:模型既要处理已有信息,也要参与计算、推导和验证过程。这与OpenAI所强调的跨领域专业能力相衔接。
自主执行,也包括理解任务的边界
OpenAI对Astra的描述同时强调能力与对齐。这里的对齐,指模型的行为是否符合人的意图和授权范围。
发布的ExploitGym honeypot图中,GPT-5.6 Sol为48.2%,Astra为0%。这项测试在困难的授权任务之外设置额外目标,观察模型是否为了完成任务而攻击这些蜜罐位置。图中的数值对应这一特定测试结果。
OpenAI通过这类测试考察的是:当原定路径遇到困难时,模型能否继续遵守任务边界。
它与“高度自主”直接相关。系统获得的行动空间越大,就越需要正确理解哪些操作属于用户目标,哪些资源并未得到授权。自主完成工作,也包含在执行过程中保留这些约束。
在同期安全说明中,OpenAI称Astra更能遵守安全限制,并为对外部署增加了监控措施,用来识别和拦截可能的越界行为。
按照OpenAI的部署思路,模型自身对意图和边界的理解,与外部监控共同构成了让用户委托任务的基础。
从一句宣告,回到它所指向的能力
把这些材料与OpenAI章程放在一起,“欢迎来到AGI时代”所指向的图景就更加具体。
电脑操作对应在实际软件中执行工作;陌生环境测试对应探索、学习和规划;科学工作流与数学研究对应专业推理和知识探索;对齐训练则对应自主执行时对用户意图的遵循。
这几组能力共同构成了OpenAI此次发布的叙事:用户提出目标,模型进入工作环境,在执行中学习和调整,调用工具推进任务,并在授权范围内交付结果。
Brockman的这句话,正是在这样的产品与能力背景下提出的。理解OpenAI为什么选择在Astra发布时谈论“AGI时代”,需要看到它展示的这套从理解到行动、从探索到交付的完整过程。
资料来源
Axios PM,The AGI era,2026年9月3日;发布简报发言的现场报道。 https://www.axios.com/newsletters/axios-pm-17e2723f-f49b-4f7d-9439-1bf9f8994b9c
OpenAI Charter。 https://openai.com/charter/
OpenAI,GPT-6 Astra: A new generation of intelligence。 https://openai.com/index/gpt-6-astra/
ARC Prize,OpenAI’s GPT-6 Astra on ARC-AGI-3,2026年9月3日。 https://arcprize.org/blog/astra
ARC Prize,GPT-6 Astra Results。 https://arcprize.org/results/openai-gpt-6-astra
OpenAI,How enabling two settings tripled our scores on the ARC-AGI-3 benchmark,2026年7月29日。 https://openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores/
OpenAI,Improved short gaps between primes。 https://cdn.openai.com/pdf/51126fac-1b68-4128-9666-c908bcc16033/short_gaps.pdf
OpenAI,GPT-6 Astra System Card,第8.2.3节;ExploitGym honeypot图。 https://deploymentsafety.openai.com/gpt-6-astra
OpenAI,Safety overview: GPT-6 Astra,2026年9月3日。 https://openai.com/index/safety-overview-gpt-6-astra/
OpenAI客户案例,Legora reviewed 41 documents in minutes with GPT-6 Astra,2026年9月3日。结果为客户披露的测试表现,4处错误为预设错误。 https://openai.com/index/legora-financial-statement-review-with-astra/
OpenAI客户案例,Playco cut manual fixes 50% prototyping games with GPT-6 Astra,2026年9月3日。50%指人工修复减少比例。 https://openai.com/index/playco-game-prototyping-with-astra/


On investment analysis, market insight, and asset allocation — not chasing short-term noise, but understanding what truly drives long-term returns.